Agent-Demos sind einfach. Agenten in Produktion sind eine Governance-Übung. Das Risiko ist selten das Modell — das Risiko ist ein Agent, der selbstbewusst aus den falschen Daten antwortet, eine Aktion ausführt, die niemand autorisiert hat, oder weiterredet, wo er längst an einen Menschen übergeben müsste.
Alle drei sind Designprobleme mit bekannten Lösungen. Das hier ist die Checkliste, die ich durchgehe, bevor ein Agentforce-Agent auch nur in die Nähe eines Kunden kommt.
Key Takeaways
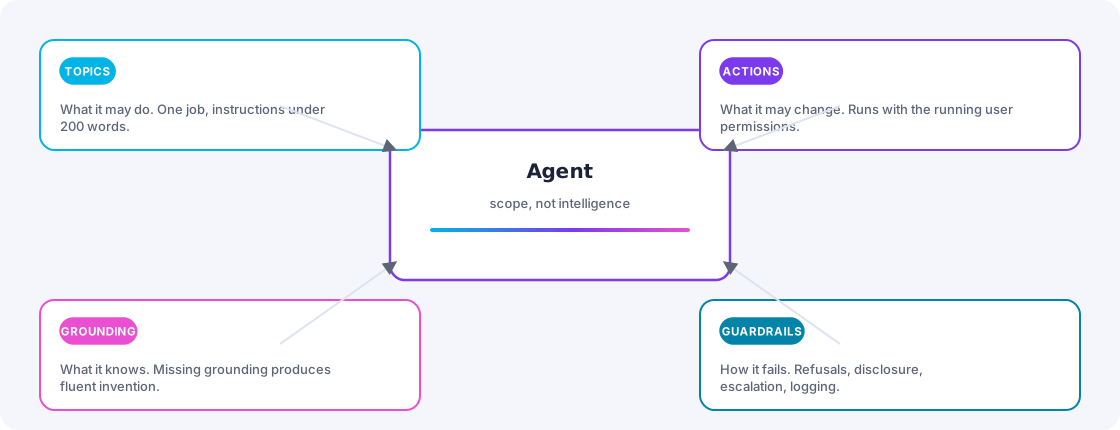
- Ein Agent ist ein Zuschnitt, keine Intelligenz. Sein Verhalten wird begrenzt durch Topics, Instruktionen, Actions und die Daten, in denen er verankert ist.
- Grounding entscheidet, was er weiß. Unverankerte Agenten scheitern nicht laut — sie improvisieren plausibel. Das ist schlimmer.
- Actions entscheiden, was er tun kann. Jede Action erbt die Berechtigungen des Running Users — der Running User ist eine Sicherheitsentscheidung.
- Eskalation ist ein Feature, kein Fallback. Die Übergabe wird vor der Konversation designt.
- Schmal shippen. Ein Topic, eine Zielgruppe, ein messbares Ergebnis, ein klarer Aus-Schalter.
Die vier Dinge, die einen Agenten definieren
Topics
Ein Topic ist ein Job, den der Agent erledigen darf — in natürlicher Sprache beschrieben, mit Instruktionen, wie. „Fragen zum Bestellstatus beantworten.” „Einem Interessenten bei der Wahl zwischen unseren zwei Service-Tiers helfen.” Jedes Topic trägt eigene Instruktionen und einen eigenen Satz erlaubter Actions.
Die Disziplin: Ein Topic ist schmal genug, wenn seine Instruktionen in unter 200 Wörtern passen und sich jede benötigte Action aufzählen lässt. Wenn nicht, sind es zwei Topics.
Actions
Actions sind das, was der Agent wirklich tun kann — einen Record abfragen, einen Flow starten, eine Apex-Methode aufrufen, etwas versenden. Das ist die Sicherheitsoberfläche. Zwei Fakten zum Verinnerlichen:
- Actions laufen als definierter Running User — dessen Berechtigungen sind die Berechtigungen des Agenten. Ein überberechtigter Service-Account gibt jeder einzelnen Konversation dieses Permission Set.
- Lese-Actions sind billig zu reviewen, Schreib-Actions nicht. Alles, was Records verändert, Nachrichten sendet oder Geld bewegt, verdient einen expliziten Freigabeschritt oder eine harte Beschränkung in der Action selbst — nicht eine hoffnungsvolle Instruktion im Topic-Prompt.
Grounding
Grounding ist, wie der Agent an Fakten kommt. Im Salesforce-Ökosystem heißt das in der Regel Retrieval über eigene Inhalte und Records — Knowledge-Artikel, Records im Sichtbereich des Running Users und unstrukturierte Inhalte, indexiert über Data 360.
Der Fehlermodus ist spezifisch und wichtig: Ein unzureichend verankerter Agent sagt nicht „Ich weiß es nicht.” Er produziert eine flüssige, sauber formatierte, komplett erfundene Antwort. Deshalb ist Grounding-Abdeckung ein Launch-Gate und kein Nice-to-have — und deshalb gehören in das erste Test-Set Fragen, von denen Sie wissen, dass das Grounding sie nicht beantworten kann. Um zu prüfen, dass der Agent ablehnt statt improvisiert.
Veralteter Content ist schlimmer als fehlender
Ein Agent, verankert in einer zwei Jahre unkuratierten Knowledge Base, zitiert selbstbewusst ein eingestelltes Produkt, eine überholte Richtlinie oder die Preise vom letzten Jahr. Bevor ein Korpus verankert wird, muss ihn jemand besitzen. Übernimmt niemand diese Ownership: Korpus ausschließen.
Guardrails
Guardrails sind alles, was Verhalten außerhalb des Happy Path begrenzt: was der Agent ablehnen muss, was er nie behaupten darf, wann er eskalieren muss, was er loggen muss und welche Daten nie in einer Antwort auftauchen dürfen.
Als explizite Instruktionen pro Topic aufschreiben — und dann adversarial testen. Jemand im Team sollte eine Stunde aktiv versuchen, dem Agenten einen Rabatt zu entlocken, ein Wettbewerber-Zitat, Ratschläge außerhalb seines Mandats oder die Daten eines anderen Kunden. Diese Stunde ist das wertvollste Testing des gesamten Projekts.
Der Eskalationspfad gehört zum Produkt
Jeder Agent braucht eine definierte Antwort auf: Was passiert, wenn das für einen echten Menschen schiefgeht?
Vor dem Launch mindestens vier Dinge entscheiden. Trigger: Welche Bedingungen erzwingen die Übergabe — expliziter Wunsch, erkannte Frustration, ein Topic außerhalb des Zuschnitts, eine gescheiterte Action, eine wiederholte Frage. Ziel: welche Queue, welcher Kanal, besetzt zu welchen Zeiten. Kontext: welches Transkript und welcher Record-Kontext mitreisen, damit der Mensch das Gespräch nicht neu beginnt. Fallback: was der Agent sagt, wenn das Ziel geschlossen ist.
Ein Agent, der nicht eskalieren kann, ist nicht autonom — er steckt fest. Und der Kunde, der das erlebt, erinnert sich daran weit länger als an die zwanzig korrekt beantworteten Fragen davor.
Den ersten Agenten zuschneiden
Das Muster, das konsistent funktioniert, ist absichtlich unambitioniert:
- Einen Job mit hohem Volumen und niedriger Konsequenz wählen. Bestellstatus, Event-Anmeldefragen, Tier-Vergleich, Doku-Lookup. Hohes Volumen liefert Daten; niedrige Konsequenz gibt Raum, falsch zu liegen.
- Eine Zielgruppe, ein Kanal. Intern vor extern ist ein legitimer und unterschätzter erster Schritt — die eigenen Kollegen geben besseres Feedback und verzeihen mehr.
- Das messbare Ergebnis vorab definieren. Deflection-Rate, First-Response-Zeit oder Aufgaben-Abschluss. Die Zahl vor dem Launch festlegen, damit Erfolg nicht rückwirkend vom Lautesten entschieden wird.
- Das Test-Set vor dem Agenten bauen. Fünfzig echte Fragen aus echten Tickets oder echten Sales-Calls, mit der korrekten Antwort daneben. Inklusive zehn, die der Agent ablehnen soll.
- Im Schattenmodus fahren. Agent entwirft, Mensch prüft und sendet — lange genug, um die Fehlermodi zu sehen. Dann für die bestandene Teilmenge auf autonom schalten.
- Instrumentieren und wöchentlich reviewen. Transkripte, Eskalationen, Ablehnungen und die Ergebnismetrik. Wöchentlich im ersten Monat, danach monatlich.
Der Aus-Schalter
Vor dem Launch aufschreiben: Wie genau wird der Agent deaktiviert, wer darf das, wie lange dauert es. Und testen. Eine Organisation, die etwas nicht in fünf Minuten ausschalten kann, wird sich beim Einschalten nicht wohlfühlen — zu Recht.
Die Fragen, die Security und Legal stellen werden
Kommen Sie ihnen zuvor — sie sind vollkommen berechtigt und werden immer irgendwann gestellt.
| Frage | Was vorliegen muss |
|---|---|
| Welche Daten sieht das Modell? | Die Grounding-Quellen, der Berechtigungsumfang des Running Users und die Datenverarbeitungs-Zusagen der Trust-Schicht der Plattform |
| Behält der Modellanbieter Kundendaten? | Eine dokumentierte Antwort aus den Trust- und Compliance-Unterlagen der Plattform — keine Annahme |
| Kann der Agent irreversible Aktionen ausführen? | Eine aufgezählte Liste der Schreib-Actions mit den Beschränkungen je Action |
| Wie auditieren wir eine schlechte Interaktion? | Wo Transkripte liegen, wie lange, und wer sie lesen darf |
| Wissen Kunden, dass sie mit einer KI sprechen? | Ihr Offenlegungstext und wo er erscheint — zunehmend regulatorische Pflicht, immer eine Vertrauensfrage |
| Was passiert im Fehlerfall? | Das Eskalationsdesign, mit Besetzung und Zeiten |
Die ehrliche Position zur Reife
Agentische Fähigkeiten im Salesforce-Ökosystem bewegen sich schnell, und die Distanz zwischen Keynote und Release Notes ist real. Das ist kein Grund auszusetzen — aber ein Grund, Use Cases zu wählen, bei denen Frühsein billig ist.
Ein sauber zugeschnittener Agent, der einen Job mit hohem Volumen erledigt, verankert in Content mit Owner, mit echtem Eskalationspfad und Aus-Schalter, ist heute ein wirklich nützliches Ding. Ein ambitionierter Agent mit breiten Topics und Schreibrechten, gelauncht um Innovativität zu beweisen, ist ein Governance-Vorfall, der auf eine nachrichtenarme Woche wartet.
Ob Ihr konkreter Use Case bereit ist, sagt Ihnen übrigens in zwei Minuten der kostenlose Use-Case-Readiness-Check (EN) — und ob Ihre Org als Ganzes die Grundlagen hat, der KI-Readiness-Score.
Häufige Fragen
Kennen Sie das aus Ihrer eigenen Org?
Das erste Gespräch ist kostenlos: dreißig Minuten, keine Folien, und eine ehrliche Einschätzung, was eine Lösung kosten würde. Wenn es sich nicht lohnt, hören Sie das auch.